Tips Mengoptimalkan GPU untuk AI di 2026, Atur Memory hingga Batch Size agar Lebih Efisien
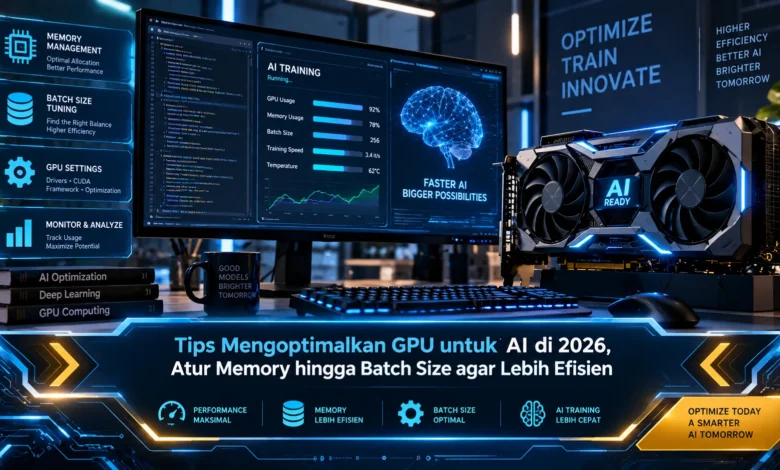
Penggunaan GPU untuk menjalankan workload AI pada 2026 semakin beragam, mulai dari inference model lokal, generative AI, hingga training dan fine tuning. Namun, GPU yang cepat belum tentu memberikan hasil optimal jika VRAM, batch size, precision, dan alokasi memory tidak dikonfigurasi dengan tepat. Dalam perkembangan TEKNOLOGI AI yang semakin intensif terhadap komputasi, memahami cara mengoptimalkan sumber daya GPU menjadi langkah penting agar performa tetap tinggi tanpa memboroskan kapasitas perangkat.
Kenali Kebutuhan GPU dan VRAM Sebelum Menjalankan AI
Langkah pertama dalam mengoptimalkan GPU untuk AI ialah mengenali karakteristik workload yang hendak dijalankan. Setiap model AI memiliki kebutuhan komputasi dan memory yang berbeda, sehingga konfigurasi yang cocok untuk satu model belum tentu ideal untuk model lainnya. Model berukuran besar biasanya menggunakan kapasitas memory GPU yang lebih besar daripada model dengan jumlah parameter lebih kecil.
Pengguna juga perlu membedakan kebutuhan training dan inference. Training biasanya memerlukan memory tambahan untuk menyimpan activation, gradient, dan berbagai state selama proses optimasi, sementara proses inferensi tidak selalu membutuhkan struktur memory sebanyak training. Dengan mengenali karakter workload, konfigurasi GPU dapat disusun secara lebih efisien.
Manajemen VRAM Menjadi Kunci Optimasi GPU AI
Pengaturan kapasitas memori grafis memiliki peranan besar dalam menentukan stabilitas proses komputasi. Memory GPU bukan sekadar tempat untuk memuat parameter model, tetapi juga dipakai untuk activation, cache, tensor sementara, serta berbagai operasi komputasi. Oleh sebab itu, menggunakan hampir seluruh memory hanya untuk model dapat membuat workload kekurangan ruang saat komputasi dimulai.
Salah satu strategi yang dapat diterapkan adalah menyediakan ruang memory tambahan untuk proses sementara. Pemakaian VRAM sebaiknya diperiksa ketika model sedang digunakan untuk mengetahui bagian yang paling banyak menghabiskan sumber daya. Apabila software lain turut memakai akselerasi grafis, menghentikan proses tersebut dapat membantu membebaskan VRAM untuk menjalankan workload AI secara lebih stabil.
Sesuaikan Batch Size dengan Kapasitas GPU
Ukuran batch memberikan dampak besar terhadap konsumsi VRAM dan throughput. Batch yang semakin besar cenderung memberikan tekanan lebih besar terhadap kapasitas memori, meskipun pada kondisi tertentu dapat meningkatkan pemanfaatan GPU. Sebaliknya, ukuran batch yang sangat rendah berpotensi membuat sebagian kemampuan komputasi GPU tidak terpakai.
Cara yang lebih praktis ialah menguji beberapa ukuran batch sembari memperhatikan konsumsi memory. Saat memory GPU mulai terpakai dalam jumlah tinggi, pengguna dapat memilih ukuran batch sebelumnya sebagai konfigurasi yang lebih stabil. Apabila kapasitas GPU tidak memungkinkan penggunaan batch besar, pengguna dapat memanfaatkan akumulasi gradient dalam beberapa iterasi agar proses training dapat menyerupai penggunaan batch lebih besar tanpa membutuhkan seluruh VRAM sekaligus.
Gunakan Mixed Precision untuk Menghemat Memory
Precision menjadi faktor penting terhadap konsumsi VRAM sekaligus kecepatan komputasi. Menggunakan precision penuh untuk seluruh operasi dapat meningkatkan kebutuhan memory meskipun beberapa proses dapat menggunakan representasi numerik yang lebih hemat. Dengan alasan tersebut, penggunaan precision campuran menjadi pendekatan menarik untuk optimalisasi GPU.
Format seperti FP16 atau BF16 berpotensi menekan konsumsi VRAM dibandingkan menjalankan seluruh komputasi dalam FP32. Pada hardware modern yang dioptimalkan untuk precision tersebut, kecepatan pemrosesan berpotensi meningkat bersamaan dengan penurunan konsumsi memory. Namun, pengguna tetap perlu memastikan model dan framework mendukung precision yang digunakan sehingga penggunaan TEKNOLOGI tersebut tetap memberikan hasil yang sesuai.
Model AI Bisa Dibuat Lebih Ringan dengan Quantization
Pengurangan precision pada bobot model dapat menjadi strategi efektif saat pengguna ingin menjalankan model yang lebih besar pada GPU terbatas. Pendekatan quantization menurunkan jumlah bit yang digunakan untuk merepresentasikan parameter, sehingga kebutuhan kapasitas memori grafis menjadi lebih rendah. Representasi 8 bit atau 4 bit dapat digunakan untuk mengurangi kebutuhan memory pada model berukuran besar.
Selain quantization, strategi seperti activation checkpointing dan pemindahan komponen tertentu ke RAM dapat dipertimbangkan ketika didukung. Metode penyimpanan activation secara selektif dapat membantu menghemat VRAM melalui proses recomputation pada tahapan tertentu. Pendekatan tersebut cukup membantu untuk GPU dengan VRAM terbatas, walaupun terdapat kemungkinan penambahan waktu komputasi.
Monitoring Menjadi Bagian Penting dalam Optimasi AI
Performa AI tidak hanya ditentukan oleh kekuatan kartu grafis, melainkan turut ditentukan oleh perangkat lunak, driver, library komputasi, serta framework. Lingkungan perangkat lunak yang telah dikonfigurasi secara tepat mampu membuat berbagai optimasi hardware digunakan secara maksimal. Di sisi lain, ketidaksesuaian software dapat membuat sebagian kemampuan GPU tidak termanfaatkan.
Pemantauan performa sebaiknya dilakukan ketika model sedang diproses untuk mengetahui komponen yang membatasi performa. Jika utilisasi GPU rendah sementara CPU bekerja sangat tinggi, bottleneck kemungkinan terjadi sebelum data mencapai GPU. Jika GPU bekerja tinggi tetapi VRAM selalu penuh, batch size, precision, cache, maupun konfigurasi model dapat diperiksa kembali. Pendekatan berbasis pengukuran lebih efektif dibandingkan sekadar menebak konfigurasi terbaik.
Kesimpulan
Optimalisasi GPU untuk workload AI pada 2026 memerlukan keseimbangan antara kecepatan komputasi, penggunaan VRAM, serta kebutuhan model. Pengelolaan VRAM, penyesuaian batch size, penggunaan mixed precision, quantization, serta monitoring performa mampu membuat sumber daya GPU dimanfaatkan secara lebih optimal. Masing masing workload mempunyai karakteristik tersendiri, sehingga pengujian konfigurasi secara bertahap tetap menjadi langkah yang penting.
Perkembangan TEKNOLOGI AI yang semakin cepat membuat efisiensi hardware menjadi semakin penting. Perangkat dengan memory besar dapat mempermudah penggunaan model kompleks, tetapi konfigurasi yang tepat tetap dapat memberikan perbedaan besar pada hardware yang tersedia. Dengan mempelajari keterkaitan VRAM, ukuran batch, format numerik, serta karakter workload, pengguna dapat membangun workflow AI yang lebih cepat, stabil, dan efisien. Pembaca dapat melakukan pengujian terukur pada workload yang digunakan agar kombinasi performa, stabilitas, dan efisiensi dapat ditemukan secara lebih akurat.